

【E2E】《Few-Shot Domain Adaptation For End-to-End Communication》
《Few-Shot Domain Adaptation For End-to-End Communication》
原文链接
为解决E2E通信中信道环境变化需重新训练编解码器的问题,提出一种小样本域自适应方法(few-shot domain adaptation)。
与传统的训练阶段无监督或半监督的域自适应方法不同,提出的方法已有一个训练好的来自源域自动编码器(在测试阶段用少量贴标签的样本适应目标域)。此外,一种基于混合高斯密度网络(Gaussian mixture density network,MDN)的生成信道模型和一种利用仿射变换(affine transformations)MDN的正则化的参数高效的自适应技术被提出。然后,学习的仿射变换用于在解码器输入处设计最优变换以补偿分布偏移,并有效地呈现到接近源分布的解码器输入。
实验证明,提出的使用少量目标域样本进行域自适应的有效性(在毫米波FPGA上测试)
1.基础知识
1.1.Notations(基本定义)
-
Input message:y∈Y:={1,⋯,m}y \in \mathcal{Y}:=\{1, \cdots, m\}y∈Y:={1,⋯,m}
-
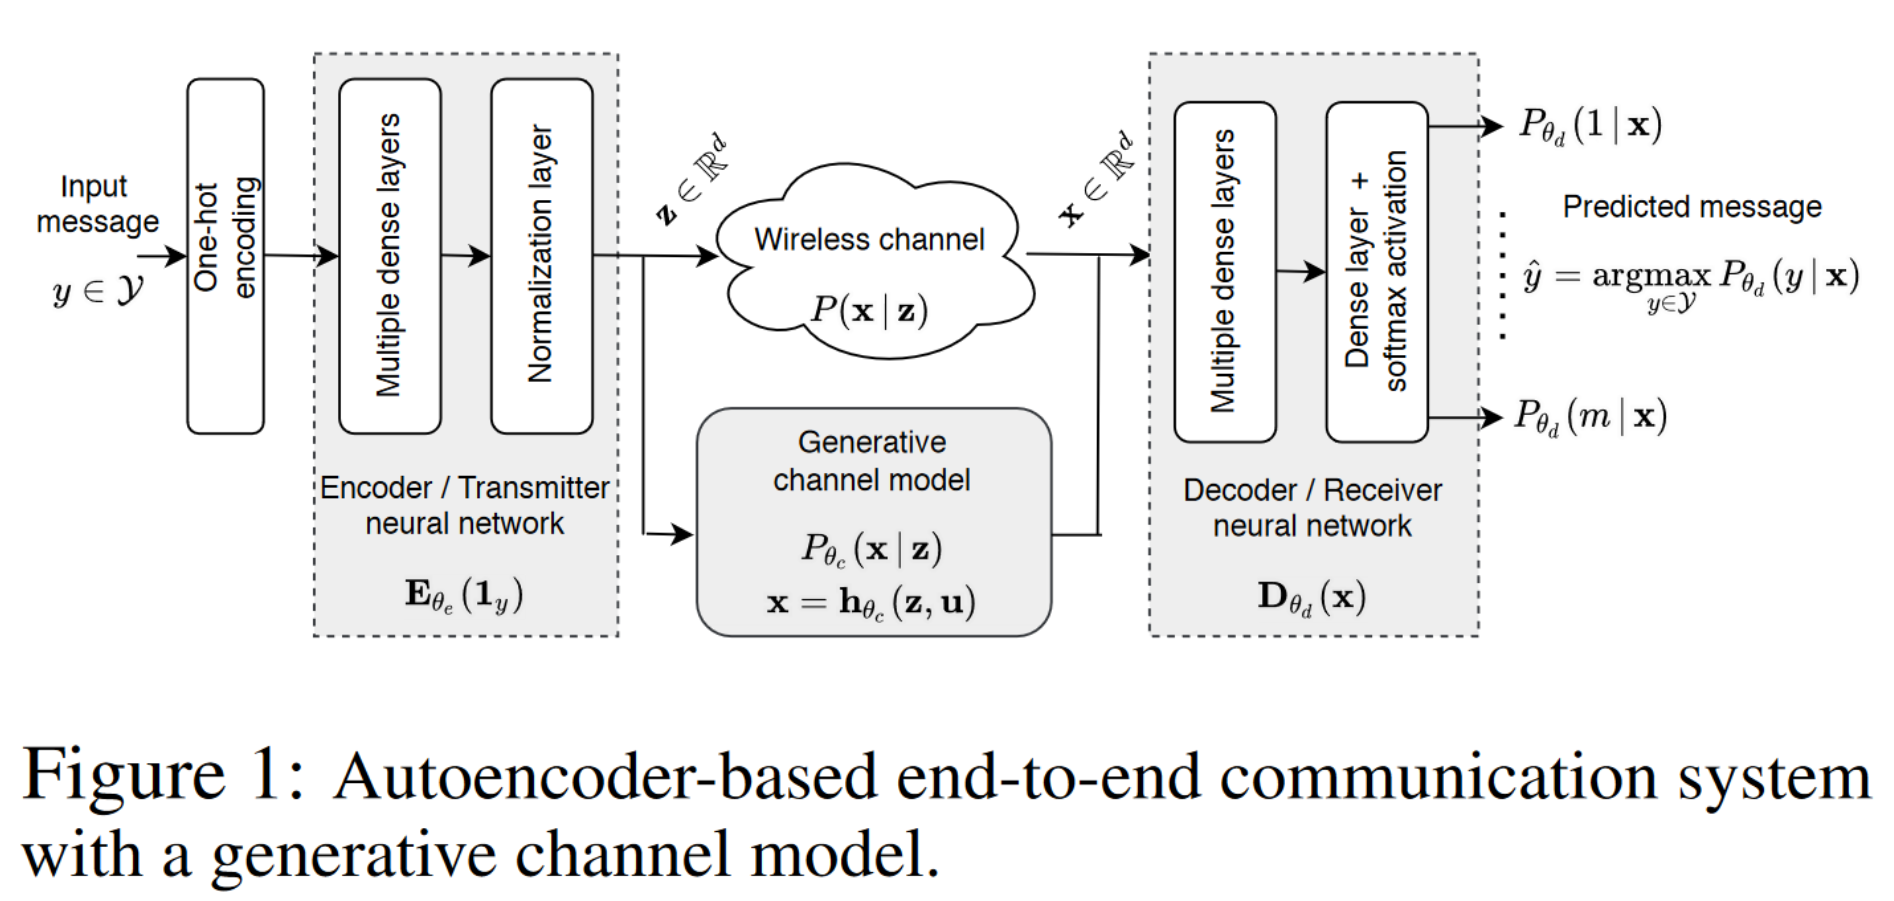
The input message yyy is mapped into a one-hot-coded vector 1y{1}_{y}1y,then get z\mathbf{z}z and Z\mathcal{Z}Z (Z\mathcal{Z}Z is the constellation of the autoencoder):
1y{1}_{y} 1y
z=Eθe(1y)\mathbf{z}=\mathbf{E}_{\boldsymbol{\theta}_e}\left(\mathbf{1}_y\right) z=Eθe(1y)
Z={Eθe(11),⋯,Eθe(1m)}\mathcal{Z}=\left\{\mathbf{E}_{\boldsymbol{\theta}_e}\left(\mathbf{1}_1\right), \cdots, \mathbf{E}_{\boldsymbol{\theta}_e}\left(\mathbf{1}_m\right)\right\} Z={Eθe(11),⋯,Eθe(1m)}
-
A communication channel, represented by an unknown conditional probability density:p(x∣z)p(\mathbf{x}|\mathbf{z})p(x∣z)
-
The decoder is essentially a classifier whose input-output mapping as below and Pθd(y∣x)P_{\boldsymbol{\theta}_d}(y \mid \mathbf{x})Pθd(y∣x) is the predicted probability of class y given x.
Dθd(x):=[Pθd(1∣x),⋯,Pθd(m∣x)]\mathbf{D}_{\boldsymbol{\theta}_d}(\mathbf{x}):=\left[P_{\boldsymbol{\theta}_d}(1 \mid \mathbf{x}), \cdots, P_{\boldsymbol{\theta}_d}(m \mid \mathbf{x})\right] Dθd(x):=[Pθd(1∣x),⋯,Pθd(m∣x)]
- The class with the highest predicted probability is the decoded message
y^(x)=argmaxy∈YPθd(y∣x)\widehat{y}(\mathbf{x})=\operatorname{argmax}_{y \in \mathcal{Y}} P_{\boldsymbol{\theta}_d}(y \mid \mathbf{x}) y(x)=argmaxy∈YPθd(y∣x)
- As in standard classification, the performance metric of the autoencoder is the symbol error rate (SER)
E(x,y)[1(y^(x)≠y)]\mathbb{E}_{(\mathbf{x}, y)}[\mathbb{1}(\widehat{y}(\mathbf{x}) \neq y)] E(x,y)[1(y(x)=y)]
1.2.Generative Channel Model(生成信道模型)
为了使用SGD优化学习编解码网络特征,decoder到encoder需要有一个可微的反向传播路径,尝试用Pθc(x∣z)P_{\boldsymbol{\theta}_c}(\mathbf{x} \mid \mathbf{z})Pθc(x∣z)近似真实信道p(x∣z)p(\mathbf{x}|\mathbf{z})p(x∣z),具体Pθc(x∣z)P_{\boldsymbol{\theta}_c}(\mathbf{x} \mid \mathbf{z})Pθc(x∣z)的建模如下
Pθc(x∣z)=∑i=1kπi(z)N(x∣μi(z),Σi(z)),z∈{Eθe(11),⋯,Eθe(1m)}P_{\boldsymbol{\theta}_c}(\mathbf{x} \mid \mathbf{z})=\sum_{i=1}^k \pi_i(\mathbf{z}) N\left(\mathbf{x} \mid \boldsymbol{\mu}_i(\mathbf{z}), \boldsymbol{\Sigma}_i(\mathbf{z})\right), \quad \mathbf{z} \in\left\{\mathbf{E}_{\boldsymbol{\theta}_e}\left(\mathbf{1}_1\right), \cdots, \mathbf{E}_{\boldsymbol{\theta}_e}\left(\mathbf{1}_m\right)\right\}Pθc(x∣z)=∑i=1kπi(z)N(x∣μi(z),Σi(z)),z∈{Eθe(11),⋯,Eθe(1m)}
该建模使用混合高斯(Gaussian mixtures),何谓Gaussian mixtures?下面详解
参考[1],
1.2.1.混合高斯模型
- 单高斯模型(Gaussian single model, GSM)
一维高斯分布的概率密度函数如下:
f(x)=12πσexp(−(x−μ)22σ2)f(x)=\frac{1}{\sqrt{2 \pi} \sigma} \exp \left(-\frac{(x-\mu)^2}{2 \sigma^2}\right)f(x)=2πσ1exp(−2σ2(x−μ)2) , X∼N(μ,σ2)X \sim N\left(\mu, \sigma^2\right)X∼N(μ,σ2)
多维变量 X=(x1,x2,…xn)X=\left(x_1, x_2, \ldots x_n\right)X=(x1,x2,…xn) 的联合概率密度函数为:
$
f(X)=\frac{1}{(2 \pi)^{d / 2}|\Sigma|^{1 / 2}} \exp \left[-\frac{1}{2}(X-u)^T \Sigma^{-1}(X-u)\right], X=\left(x_1, x_2 \ldots x_n\right)
$
其中:
ddd :变量维度。对于二维高斯分布,有 d=2\mathrm{d}=2d=2;
u=(u1u2⋯un)u=\left(\begin{array}{l}u_1 \\ u_2 \\ \cdots \\ u_n\end{array}\right)u=u1u2⋯un , 各维变量的均值;
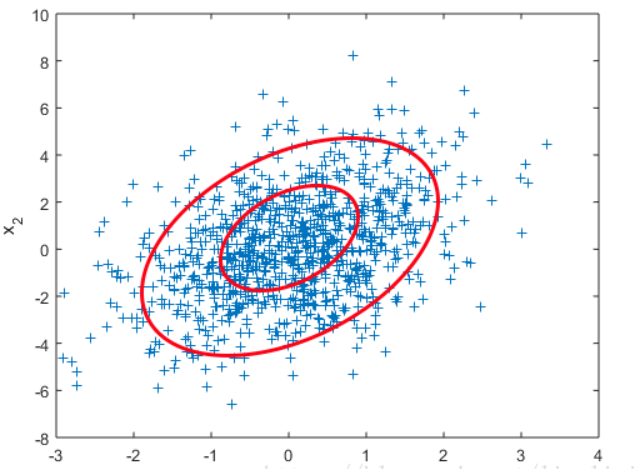
Σ\SigmaΣ : 协方差矩阵,描述各维变量之间的相关度。对于二维高斯分布有:
Σ=[δ11δ12δ21δ22]\Sigma=\left[\begin{array}{ll} \delta_{11} & \delta_{12} \\ \delta_{21} & \delta_{22} \end{array}\right] Σ=[δ11δ21δ12δ22]
- 混合高斯模型(Gaussian mixture model, GMM)
更一般化的描述为:假设混合高斯模型由K个高斯模型组成(即数据包含K个类),则GMM的概率密度函数如下:
p(x)=∑k=1Kp(k)p(x∣k)=∑k=1KπkN(x∣uk,Σk)p(x)=\sum_{k=1}^K p(k) p(x \mid k)=\sum_{k=1}^K \pi_k N\left(x \mid u_k, \Sigma_k\right) p(x)=k=1∑Kp(k)p(x∣k)=k=1∑KπkN(x∣uk,Σk)
其中, p(x∣k)=N(x∣uk,Σk)p(x \mid k)=N\left(x \mid u_k, \Sigma_k\right)p(x∣k)=N(x∣uk,Σk) 是第 个kkk 高斯模型的概率密度函数,可以看成选定第 个模kkk 型后, 该模型产生xxx的概率; p(k)=πkp(k)=\pi_kp(k)=πk 是第 kkk 个高斯模型的权重,称作选择第 kkk 个模型的先验概率,且满足 ∑k=1Kπk=1\sum_{k=1}^K \pi_k=1∑k=1Kπk=1。
所以,混合高斯模型并不是什么新奇的东西,它的本质就是融合几个单高斯模型,来使得模型更加复杂,从而产生更复杂的样本。理论上,如果某个混合高斯模型融合的高斯模型个数足够多,它们之间的权重设定得足够合理,这个混合模型可以拟合任意分布的样本。
1.2.2.混合高斯模型(本文的应用)
本文对于Pθc(x∣z)P_{\boldsymbol{\theta}_c}(\mathbf{x} \mid \mathbf{z})Pθc(x∣z)的建模是混合高斯模型
Pθc(x∣z)=∑i=1kπi(z)N(x∣μi(z),Σi(z)),z∈{Eθe(11),⋯,Eθe(1m)}P_{\boldsymbol{\theta}_c}(\mathbf{x} \mid \mathbf{z})=\sum_{i=1}^k \pi_i(\mathbf{z}) N\left(\mathbf{x} \mid \boldsymbol{\mu}_i(\mathbf{z}), \boldsymbol{\Sigma}_i(\mathbf{z})\right), \quad \mathbf{z} \in\left\{\mathbf{E}_{\boldsymbol{\theta}_e}\left(\mathbf{1}_1\right), \cdots, \mathbf{E}_{\boldsymbol{\theta}_e}\left(\mathbf{1}_m\right)\right\}Pθc(x∣z)=∑i=1kπi(z)N(x∣μi(z),Σi(z)),z∈{Eθe(11),⋯,Eθe(1m)}
πi(z)\pi_i(\mathbf{z})πi(z)可以用softmaxsoftmaxsoftmax函数建模, πi(z)=eαi(z)/∑j=1keαj(z),∀i∈[k]\pi_i(\mathbf{z})=e^{\alpha_i(\mathbf{z})} / \sum_{j=1}^k e^{\alpha_j(\mathbf{z})}, \forall i \in[k]πi(z)=eαi(z)/∑j=1keαj(z),∀i∈[k],其中αi(z)∈R\alpha_i(\mathbf{z}) \in \mathbb{R}αi(z)∈R是Prior logits的一部分。
对于包含iii的未知变量参数化,ϕi(z)T=[αi(z),μi(z)T\phi_i(\mathbf{z})^T=\left[\alpha_i(\mathbf{z}), \boldsymbol{\mu}_i(\mathbf{z})^T\right.ϕi(z)T=[αi(z),μi(z)T, vec(Σi(z))T]\left.\operatorname{vec}\left(\boldsymbol{\Sigma}_i(\mathbf{z})\right)^T\right]vec(Σi(z))T]
结合所有的参数,ϕ(z)T=[ϕ1(z)T,⋯,ϕk(z)T]\phi(\mathbf{z})^T=\left[\phi_1(\mathbf{z})^T, \cdots, \phi_k(\mathbf{z})^T\right]ϕ(z)T=[ϕ1(z)T,⋯,ϕk(z)T]
备注:Prior logits是指在一个分类模型中,每个类别的先验概率对应的logit值。在softmax回归中,每个类别的概率由其对应的logit值通过softmax函数转换而来。在有些情况下,我们可能需要在训练过程中对先验概率进行调整,这时我们可以通过修改prior logits的值来实现。例如,在样本类别分布不均衡的情况下,我们可以通过增加少数类别的prior logits的值来平衡样本分布,从而提高模型的性能。
1.2.3.预测参数
利用高斯混合密度网络(Gaussian mixture density network,MDN)预测建模Pθc(x∣z)P_{\boldsymbol{\theta}_c}(\mathbf{x} \mid \mathbf{z})Pθc(x∣z)的混合高斯模型的参数Mθc\mathbf{M}_{\boldsymbol{\theta}_c}Mθc , ϕ(z)=Mθc(z)\phi(\mathbf{z})=\mathbf{M}_{\boldsymbol{\theta}_c}(\mathbf{z})ϕ(z)=Mθc(z),θc{\theta}_cθc即为MDN网络的参数
1.3小结
为什么使用MDN?
- 强大的近似拟合能力
- 便于分析计算,适用于这里域自适应的场景
- 对于无线通信建模是有效的
autoencoder的输入输出函数如下:
fθ(1y)=Dθd(hθc(Eθe(1y),u))\mathbf{f}_{\boldsymbol{\theta}}\left(\mathbf{1}_y\right)=\mathbf{D}_{\boldsymbol{\theta}_d}\left(\mathbf{h}_{\boldsymbol{\theta}_c}\left(\mathbf{E}_{\boldsymbol{\theta}_e}\left(\mathbf{1}_y\right), \mathbf{u}\right)\right)fθ(1y)=Dθd(hθc(Eθe(1y),u))
需要说明的是,信道采样函数hθc\mathbf{h}_{\boldsymbol{\theta}_c}hθc不可微,需借助Gumbel-Softmax。
2.提出的方法
2.1.问题描述
x\mathbf{x}x: channel output,
yyy: message (class label),
z\mathbf{z}z: input (symbol)
p(x,y,z)p(\mathbf{x}, y, \mathbf{z})p(x,y,z):joint distribution
2.1.1.建立联合分布
p(x,y,z)p(\mathbf{x}, y, \mathbf{z})p(x,y,z)和p(x,y)p(\mathbf{x}, y)p(x,y)的联合分布如下,δ(⋅)\delta(\cdot)δ(⋅)是脉冲函数,定义p(x∣y):=p(x∣Eθe(1y))p(\mathbf{x} \mid y):=p\left(\mathbf{x} \mid \mathbf{E}_{\boldsymbol{\theta}_{\boldsymbol{e}}}\left(\mathbf{1}_y\right)\right)p(x∣y):=p(x∣Eθe(1y))是给定类别yyy后x\mathbf{x}x的条件分布
p(x,y,z)=p(x∣Eθe(1y))p(y)δ(z−Eθe(1y)),∀x,z∈Rd,y∈Yp(\mathbf{x}, y, \mathbf{z})=p\left(\mathbf{x} \mid \mathbf{E}_{\boldsymbol{\theta}_e}\left(\mathbf{1}_y\right)\right) p(y) \delta\left(\mathbf{z}-\mathbf{E}_{\boldsymbol{\theta}_e}\left(\mathbf{1}_y\right)\right), \quad \forall \mathbf{x}, \mathbf{z} \in \mathbb{R}^d, y \in \mathcal{Y} p(x,y,z)=p(x∣Eθe(1y))p(y)δ(z−Eθe(1y)),∀x,z∈Rd,y∈Y
p(x,y)=p(x∣Eθe(1y))p(y),∀x∈Rd,y∈Yp(\mathbf{x}, y)=p\left(\mathbf{x} \mid \mathbf{E}_{\boldsymbol{\theta}_e}\left(\mathbf{1}_y\right)\right) p(y), \forall \mathbf{x} \in \mathbb{R}^d, y \in \mathcal{Y} p(x,y)=p(x∣Eθe(1y))p(y),∀x∈Rd,y∈Y
2.1.2.数据收集
Ds={(xis,yis,zis),i=1,⋯,Ns}\mathcal{D}^s=\left\{\left(\mathbf{x}_i^s, y_i^s, \mathbf{z}_i^s\right), i=1, \cdots, N^s\right\}Ds={(xis,yis,zis),i=1,⋯,Ns}是
来自源分布ps(x,y,z)=ps(x∣y)ps(y)δ(z−Eθe(1y))p^s(\mathbf{x}, y, \mathbf{z})=p^s(\mathbf{x} \mid y) p^s(y) \delta\left(\mathbf{z}-\mathbf{E}_{\boldsymbol{\theta}_e}\left(\mathbf{1}_y\right)\right)ps(x,y,z)=ps(x∣y)ps(y)δ(z−Eθe(1y))的数据集
MDN和autoencoder也是基于此数据集训练
2.1.3.信道环境变化
变化后的分布为:
pt(x,y,z)=pt(x∣y)pt(y)δ(z−Eθe(1y))p^t(\mathbf{x}, y, \mathbf{z})=p^t(\mathbf{x} \mid y) p^t(y) \delta\left(\mathbf{z}-\mathbf{E}_{\boldsymbol{\theta}_e}\left(\mathbf{1}_y\right)\right)pt(x,y,z)=pt(x∣y)pt(y)δ(z−Eθe(1y))
从目标分布搜集一个小数据集:
Dt={(xit,yit,zit),i=1,⋯,Nt}\mathcal{D}^t=\left\{\left(\mathbf{x}_i^t, y_i^t, \mathbf{z}_i^t\right), i=1, \cdots, N^t\right\}Dt={(xit,yit,zit),i=1,⋯,Nt} , Nt< Our goal is to design a few-shot domain adaptation for the MDN and autoencoder in order to maintain or improve the symbol error rate. 合理假设下,输入信息yyy的的先验概率不变:pt(y)≈ps(y),∀y∈Yp^t(y) \approx p^s(y), \forall y \in \mathcal{Y}pt(y)≈ps(y),∀y∈Y 信道输出的类条件分布变化:p(x∣y)p(\mathbf{x} \mid y)p(x∣y) 因此类后验分布也变化:p(y∣x)p( y\mid \mathbf{x})p(y∣x) 对于Pθc(x∣z)P_{\boldsymbol{\theta}_c}(\mathbf{x} \mid \mathbf{z})Pθc(x∣z)的建模是混合高斯模型,假设与该高斯模型需要拟合的目标的类条件分布是: Pθ^c(x∣z)=∑i=1kπ^i(z)N(x∣μ^i(z),Σ^i(z)),z∈{Eθe(11),⋯,Eθe(1m)}P_{\widehat{\boldsymbol{\theta}}_c}(\mathbf{x} \mid \mathbf{z})=\sum_{i=1}^k \widehat{\pi}_i(\mathbf{z}) N\left(\mathbf{x} \mid \widehat{\boldsymbol{\mu}}_i(\mathbf{z}), \widehat{\boldsymbol{\Sigma}}_i(\mathbf{z})\right), \quad \mathbf{z} \in\left\{\mathbf{E}_{\boldsymbol{\theta}_e}\left(\mathbf{1}_1\right), \cdots, \mathbf{E}_{\boldsymbol{\theta}_e}\left(\mathbf{1}_m\right)\right\}Pθc(x∣z)=∑i=1kπi(z)N(x∣μi(z),Σi(z)),z∈{Eθe(11),⋯,Eθe(1m)}, θ^c\widehat{\boldsymbol{\theta}}_cθc:则为适应的MDN的参数 自适应的MDN预测目标混合高斯的参数:ϕ^(z)=Mθ^c(z)\widehat{\phi}(\mathbf{z})=\mathbf{M}_{\widehat{\boldsymbol{\theta}}_c}(\mathbf{z})ϕ(z)=Mθc(z) [外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-i2qoX63h-1678952890076)(null)] 不同于对MDN所有参数本地fine-tuning,提出了基于高斯分布affine-transformation属性的的参数高效自适应方法,即一种通过affine-transformation可以在任意两个多元高斯间的变化 两个假设: 源高斯混合模型和目标高斯混合模型之间的参数变换如下 1.详解EM算法与混合高斯模型(Gaussian mixture model, GMM)
(备注:信道输出的类条件分布是指通信信道接收到某个特定符号或信息后的输出信号的概率分布。换句话说,它描述了在考虑信道特性的情况下,特定输入符号产生特定输出信号的可能性。
信道输出的类条件分布(class-conditional distribution of channel output)通常使用概率密度函数进行建模,例如高斯或泊松分布,具体取决于信道类型和传输信号的特性。该分布是通信理论中的重要概念,用于设计和分析通信系统,例如数字调制方案和纠错编码。
在实践中,信道输出的类条件分布可能会受到各种因素的影响,包括噪声、干扰、衰减和失真等。因此,设计能够应对这些影响并确保信息可靠传输的通信系统非常重要。)
(备注:类后验分布(class-posterior distribution)是指在给定观测值的情况下,某个样本属于每个类别的概率分布。也就是说,对于一个给定的观测值,类后验分布可以告诉我们这个观测值属于每个类别的概率大小。
在分类问题中,类后验分布是分类器的输出结果之一,它可以用于选择分类器最终输出的类别。例如,如果某个样本的类后验分布表明它属于第一个类别的概率更高,那么分类器就可以将其划分到第一个类别。
类后验分布可以通过贝叶斯定理得到,其中观测值是先验信息,类别是待求解的后验信息。它在许多机器学习算法中都有广泛应用,例如朴素贝叶斯分类器、支持向量机和决策树等。
需要注意的是,类后验分布的准确性取决于训练数据的质量和数量,以及所采用的特征和模型。因此,在实际应用中,需要仔细选择和设计特征和模型,以获得更准确和可靠的类后验分布。)2.2.提出的方法
2.3.MDN信道模型自适应
2.2.1.affine-transformation
2.2.2.参数转换(Parameter Transformations)
μ^i(z)=Aiμi(z)+bi,Σ^i(z)=CiΣi(z)CiT,and α^i(z)=βiαi(z)+γi\widehat{\boldsymbol{\mu}}_i(\mathbf{z})=\mathbf{A}_i \boldsymbol{\mu}_i(\mathbf{z})+\mathbf{b}_i, \quad \widehat{\boldsymbol{\Sigma}}_i(\mathbf{z})=\mathbf{C}_i \boldsymbol{\Sigma}_i(\mathbf{z}) \mathbf{C}_i^T, \text { and } \widehat{\alpha}_i(\mathbf{z})=\beta_i \alpha_i(\mathbf{z})+\gamma_i μi(z)=Aiμi(z)+bi,Σi(z)=CiΣi(z)CiT, and αi(z)=βiαi(z)+γiReference