

决策树在sklearn中的实现
目录
一.模块sklearn.tree
二.建模基本流程
三.DecisionTreeClassifier重要参数
1.criterion
2.random_state & splitter
3.剪枝参数max_depth
4.剪枝参数min_samples_leaf & min_samples_split
5.max_features & min_impurity_decrease
6.class_weight & min_weight_fraction_leaf
7.总结
四.DecisionTreeRegressor重要参数
1.criterion
2.交叉验证
五.泰坦尼克号幸存者预测
六.用回归树拟合正弦曲线
一.模块sklearn.tree
sklearn中决策树的类都在”tree“这个模块之下。这个模块总共包含五个类:
tree.DecisionTreeClassifier 分类树
tree.DecisionTreeRegressor 回归树
tree.export_graphviz 将生成的决策树导出为DOT格式,画图专用
tree.ExtraTreeClassifier 高随机版本的分类树
tree.ExtraTreeRegressor 高随机版本的回归树
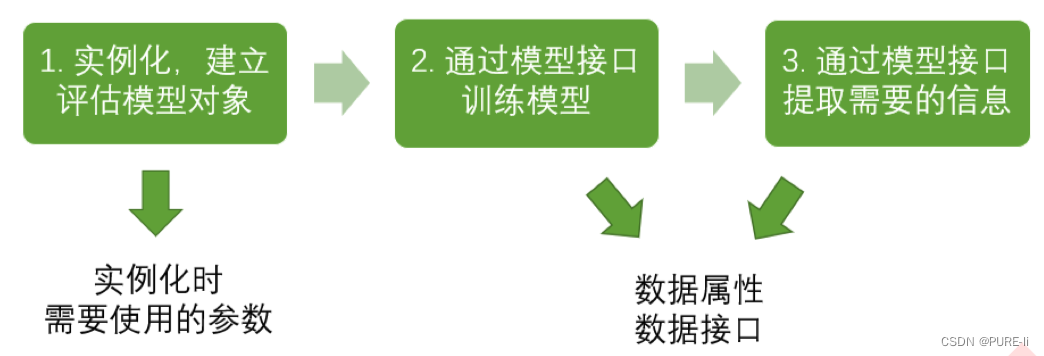
二.建模基本流程
三.DecisionTreeClassifier重要参数
1.criterion
为了要将表格转化为一棵树,决策树需要找出最佳节点和最佳的分枝方法,对分类树来说,衡量这个“最佳”的指标叫做“不纯度”。通常来说,不纯度越低,决策树对训练集的拟合越好。现在使用的决策树算法在分枝方法上的核心大多是围绕在对某个不纯度相关指标的最优化上。
Criterion这个参数正是用来决定不纯度的计算方法的。sklearn提供了两种选择:
1)输入”entropy“,使用信息熵(Entropy)
2)输入”gini“,使用基尼系数(Gini Impurity)
比起基尼系数,信息熵对不纯度更加敏感,对不纯度的惩罚最强。但是在实际使用中,信息熵和基尼系数的效果基本相同。信息熵的计算比基尼系数缓慢一些,因为基尼系数的计算不涉及对数。另外,因为信息熵对不纯度更加敏感,所以信息熵作为指标时,决策树的生长会更加“精细”,因此对于高维数据或者噪音很多的数据,信息熵很容易过拟合,基尼系数在这种情况下效果往往比较好。当模型拟合程度不足的时候,即当模型在训练集和测试集上都表现不太好的时候,使用信息熵。当然,这些不是绝对的。不填默认基尼系数,填写gini使用基尼系数,填写entropy使用信息增益.通常就使用基尼系数.数据维度很大,噪音很大时使用基尼系数.维度低,数据比较清晰的时候,信息熵和基尼系数没区别当决策树的拟合程度不够的时候,使用信息熵.两个都试试,不好就换另外一个.
2.random_state & splitter
random_state用来设置分枝中的随机模式的参数,默认None,在高维度时随机性会表现更明显,低维度的数据(比如鸢尾花数据集),随机性几乎不会显现。输入任意整数,会一直长出同一棵树,让模型稳定下来。
splitter也是用来控制决策树中的随机选项的,有两种输入值,输入”best",决策树在分枝时虽然随机,但是还是会优先选择更重要的特征进行分枝(重要性可以通过属性feature_importances_查看),输入“random",决策树在分枝时会更加随机,树会因为含有更多的不必要信息而更深更大,并因这些不必要信息而降低对训练集的拟合。这也是防止过拟合的一种方式。当你预测到你的模型会过拟合,用这两个参数来帮助你降低树建成之后过拟合的可能性。当然,树一旦建成,我们依然是使用剪枝参数来防止过拟合。
3.剪枝参数max_depth
剪枝策略对决策树的影响巨大,正确的剪枝策略是优化决策树算法的核心,用于处理过拟合.
max_depth限制树的最大深度,超过设定深度的树枝全部剪掉.这是用得最广泛的剪枝参数,在高维度低样本量时非常有效。决策树多生长一层,对样本量的需求会增加一倍,所以限制树深度能够有效地限制过拟合。在集成算法中也非常实用。实际使用时,建议从=3开始尝试,看看拟合的效果再决定是否增加设定深度。
4.剪枝参数min_samples_leaf & min_samples_split
min_samples_leaf限定,一个节点在分枝后的每个子节点都必须包含至少min_samples_leaf个训练样本,否则分枝就不会发生,或者,分枝会朝着满足每个子节点都包含min_samples_leaf个样本的方向去发生.
一般搭配max_depth使用,在回归树中有神奇的效果,可以让模型变得更加平滑。这个参数的数量设置得太小会引起过拟合,设置得太大就会阻止模型学习数据。一般来说,建议从=5开始使用。如果叶节点中含有的样本量变化很大,建议输入浮点数作为样本量的百分比来使用。同时,这个参数可以保证每个叶子的最小尺寸,可以在回归问题中避免低方差,过拟合的叶子节点出现。对于类别不多的分类问题,=1通常就是最佳选择。min_samples_split限定,一个节点必须要包含至少min_samples_split个训练样本,这个节点才允许被分枝,否则分枝就不会发生。
5.max_features & min_impurity_decrease
一般max_depth使用,用作树的”精修“
max_features限制分枝时考虑的特征个数,超过限制个数的特征都会被舍弃。和max_depth异曲同工,max_features是用来限制高维度数据的过拟合的剪枝参数,但其方法比较暴力,是直接限制可以使用的特征数量而强行使决策树停下的参数,在不知道决策树中的各个特征的重要性的情况下,强行设定这个参数可能会导致模型学习不足。如果希望通过降维的方式防止过拟合,建议使用PCA,ICA或者特征选择模块中的降维算法。min_impurity_decrease限制信息增益的大小,信息增益小于设定数值的分枝不会发生。这是在0.19版本中更新的功能,在0.19版本之前时使用min_impurity_split。
6.class_weight & min_weight_fraction_leaf
有了权重之后,样本量就不再是单纯地记录数目,而是受输入的权重影响了,因此这时候剪枝,就需要搭配min_ weight_fraction_leaf这个基于权重的剪枝参数来使用。另请注意,基于权重的剪枝参数(例如min_weight_fraction_leaf)将比不知道样本权重的标准(比如min_samples_leaf)更少偏向主导类。如果样本是加权的,则使用基于权重的预修剪标准来更容易优化树结构,这确保叶节点至少包含样本权重的总和的一小部分。
7.总结
八个参数:Criterion,两个随机性相关的参数(random_state,splitter),五个剪枝参数(max_depth, min_samples_split,min_samples_leaf,max_feature,min_impurity_decrease)
一个属性:feature_importances_
四个接口:fit,score,apply,predict
四.DecisionTreeRegressor重要参数
1.criterion
回归树衡量分枝质量的指标,支持的标准有三种:
1)输入"mse"使用均方误差mean squared error(MSE),父节点和叶子节点之间的均方误差的差额将被用来作为特征选择的标准,这种方法通过使用叶子节点的均值来最小化L2损失
2)输入“friedman_mse”使用费尔德曼均方误差,这种指标使用弗里德曼针对潜在分枝中的问题改进后的均方误差
3)输入"mae"使用绝对平均误差MAE(mean absolute error),这种指标使用叶节点的中值来最小化L1损失
属性中最重要的依然是feature_importances_,接口依然是apply, fit, predict, score最核心。
回归树的接口score返回的是R平方,并不是MSE。
虽然均方误差永远为正,但是sklearn当中使用均方误差作为评判标准时,却是计算”负均方误差“(neg_mean_squared_error)。
2.交叉验证
交叉验证是用来观察模型的稳定性的一种方法,我们将数据划分为n份,依次使用其中一份作为测试集,其他n-1份作为训练集,多次计算模型的精确性来评估模型的平均准确程度。训练集和测试集的划分会干扰模型的结果,因此用交叉验证n次的结果求出的平均值,是对模型效果的一个更好的度量。
五.泰坦尼克号幸存者预测
import pandas as pd
from sklearn.tree import DecisionTreeClassifier
from sklearn.model_selection import train_test_split
from sklearn.model_selection import GridSearchCV
from sklearn.model_selection import cross_val_score#交叉验证
import matplotlib.pyplot as plt
# data = pd.read_csv(r"./data.csv",index_col = 0)
data = pd.read_csv(r"./data.csv")
# print(data)
data.drop(["Cabin","Name","Ticket"],inplace=True,axis=1)
data["Age"] = data["Age"].fillna(data["Age"].mean())
data = data.dropna(axis=0)#drop中axis=0表示行
labels = data["Embarked"].unique().tolist()
data["Sex"] = (data["Sex"]== "male").astype("int")#男人为1,女人为0
# print(labels)
data["Embarked"] = data["Embarked"].apply(lambda x: labels.index(x))
# print(labels.index("S"))
# print(labels.index("C"))
# print(labels.index("Q"))
X = data.iloc[:,data.columns != "Survived"]
# print(X)
y = data.iloc[:,data.columns == "Survived"]
Xtrain, Xtest, Ytrain, Ytest = train_test_split(X,y,test_size=0.3)
for i in [Xtrain, Xtest, Ytrain, Ytest]:#修正测试集和训练集的索引,把索引恢复到0到某个数i.index = range(i.shape[0])
clf = DecisionTreeClassifier(random_state=25)#实例化,random_state为种子,用于固定
clf = clf.fit(Xtrain, Ytrain)#进行训练
score_ = clf.score(Xtest, Ytest)#分数为精确度
print(score_)
score = cross_val_score(clf,X,y,cv=10).mean()#使用交叉验证求精确度,传入全部数据,不仅仅是测试集
print(score)
tr = []
te = []
for i in range(10):clf = DecisionTreeClassifier(random_state=25#实例化,random_state为种子,用于固定,max_depth=i+1,criterion="entropy")clf = clf.fit(Xtrain, Ytrain)score_tr = clf.score(Xtrain,Ytrain)#训练集的精确度score_te = cross_val_score(clf,X,y,cv=10).mean()#交叉验证,传入全部数据,不仅仅是测试集tr.append(score_tr)te.append(score_te)
print(max(te))
plt.plot(range(1,11),tr,color="red",label="train")
plt.plot(range(1,11),te,color="blue",label="test")
plt.xticks(range(1,11))#让他乖乖显示1-10的整数
plt.legend()
# plt.show()
import numpy as np
gini_thresholds = np.linspace(0,0.5,20)#基尼系数取值范围为0-0.5
entropy_thresholds = np.linspace(0,1,20)#信息增益取值范围为0-1
parameters = {'splitter':('best','random')#网格搜索参数设置,'criterion':("gini","entropy"),"max_depth":[*range(1,10)],'min_samples_leaf':[*range(1,50,5)],'min_impurity_decrease':[*np.linspace(0,0.5,20)]#np.linspace(0,0.5,20)在0-0.5之间取20个数}
clf = DecisionTreeClassifier(random_state=25)#模型实例化
GS = GridSearchCV(clf, parameters, cv=10)#配备网格搜索
GS.fit(Xtrain,Ytrain)#对网格搜索传入数据
print(GS.best_params_)#从我们输入的参数和参数取值的列表中,返回最佳组合
print(GS.best_score_)#网格搜索后的模型的评判标准,是建立在最佳组合的基础上
/Users/lichengxiang/opt/anaconda3/bin/python /Users/lichengxiang/Desktop/python/菜菜的机器学习/泰坦尼克号幸存者预测.py
0.704119850187266
0.7469611848825333
0.8166624106230849
{'criterion': 'gini', 'max_depth': 3, 'min_impurity_decrease': 0.0, 'min_samples_leaf': 1, 'splitter': 'best'}
0.8264464925755248进程已结束,退出代码0
六.用回归树拟合正弦曲线
import numpy as np
from sklearn.tree import DecisionTreeRegressor
import matplotlib.pyplot as plt
rng=np.random.RandomState(1)#设置种子,固定生成的值
X = np.sort(5 * rng.rand(80,1), axis=0)#rng.rand(80,1)生成80行1列的大小为(0,1)的二维数组
print(np.sin(X))
print(np.sin(X).ravel())
y = np.sin(X).ravel()#ravel将二维数组降维为一维数组
y[::5] += 3 * (0.5 - rng.rand(16))#制造噪声
# plt.scatter(X, y, s=20, edgecolor="black",c="darkorange", label="data")
# plt.show()
regr_1 = DecisionTreeRegressor(max_depth=2)#决策树
regr_2 = DecisionTreeRegressor(max_depth=5)
regr_1.fit(X, y)#训练
regr_2.fit(X, y)
X_test = np.arange(0.0, 5.0, 0.01)[:, np.newaxis]#生成测试集的x,np.newaxis进行升维,升维成2维
print(X_test)
y_1 = regr_1.predict(X_test)#这个传进去的X_test是二维数组,生成的是一维数组
print(y_1)
y_2 = regr_2.predict(X_test)
plt.figure()
plt.scatter(X, y, s=20, edgecolor="black",c="darkorange", label="data")
plt.plot(X_test, y_1, color="cornflowerblue",label="max_depth=2", linewidth=2)
plt.plot(X_test, y_2, color="yellowgreen", label="max_depth=5", linewidth=2)
plt.xlabel("data")
plt.ylabel("target")
plt.title("Decision Tree Regression")
plt.legend()#图例
plt.show()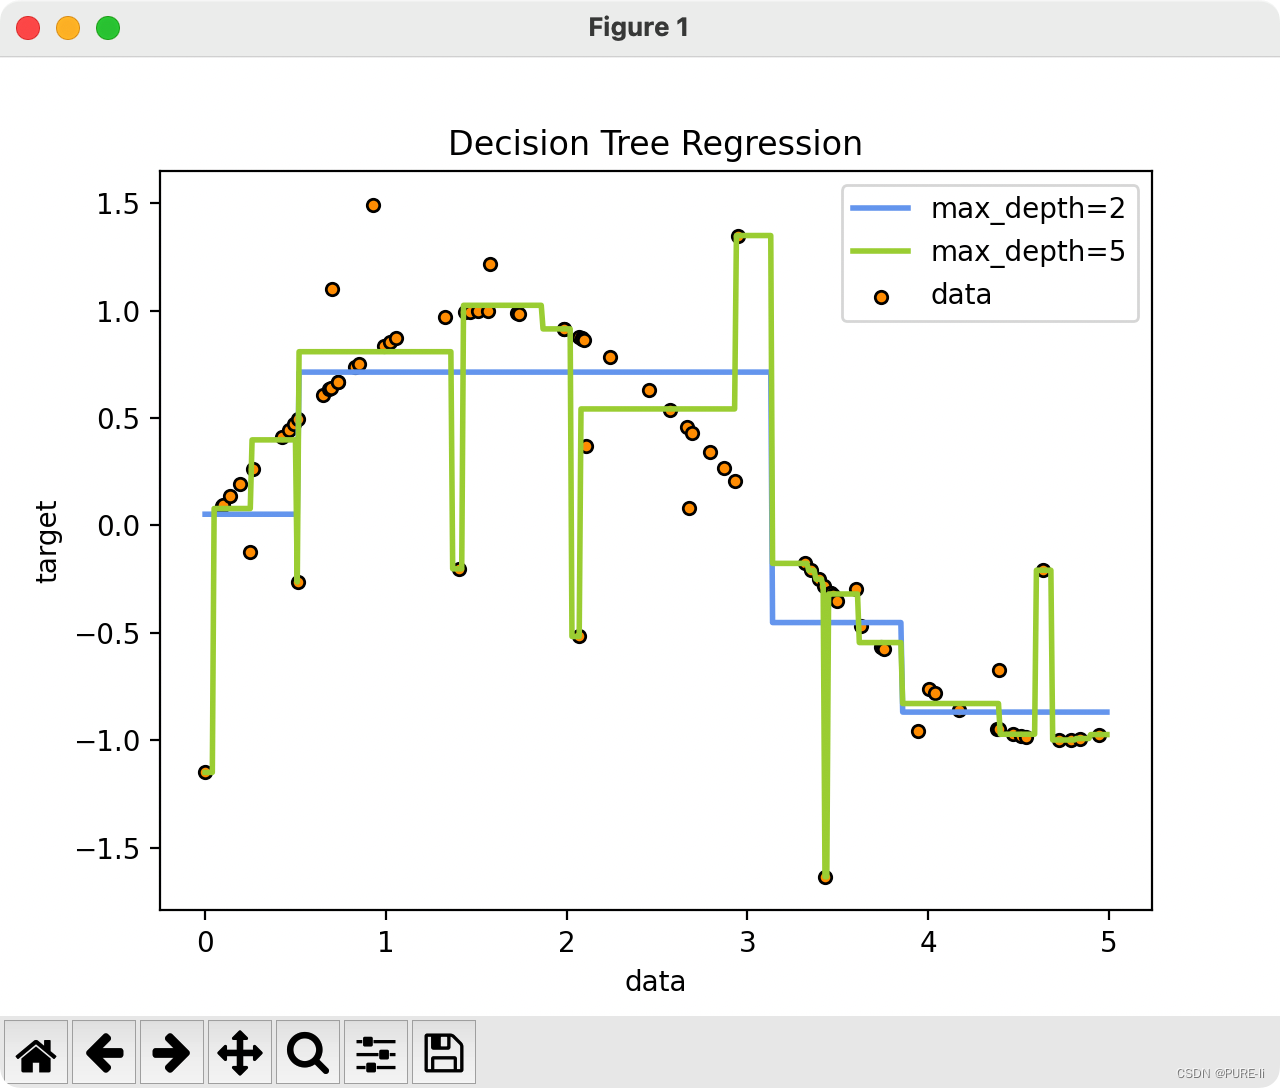
上一篇:拒绝摆烂,Android AMS应该打卡学习的n件事
下一篇:“优酷原创”厂牌亮相